线段树
**线段树(Segment Tree)**主要用于查询一个区间内的最大值、最小值或元素之和。它是一种二叉搜索树,与区间树相似:把一个区间划分成若干单元区间,每个单元区间对应线段树中的一个叶子节点。借助线段树可以快速查找某个节点在若干条线段中出现的次数,时间复杂度为 O(logN)。
未优化的空间复杂度为 2N,实际应用时一般还要开 4N 的数组以免越界,因此有时需要通过离散化来压缩空间。
线段树的原理
E[] tree:线段树数组;E[] data:线段树的私有数组,存储传入的数组;Merger<E> merger:一个函数式接口,用于对线段树查到的区间值进行合并。public SegmentTree(E[] arr, Merger<E> merger):把传入的数组初始化到data,初始化接口,再调用buildSegmentTree()。buildSegmentTree(int treeIndex, int l, int r):构建线段树。E get(int index):得到下标为 index 的值。getSize():得到传入数组的大小。leftChild(index)/rightChild(index):得到下标为 index 的左右孩子的下标。query(int queryL, int queryR):公共接口,调用重载函数query(treeIndex, l, r, queryL, queryR)。query(int treeIndex, int l, int r, int queryL, int queryR):查找一个区间内的元素并做 Merger 操作。set(int index, E e):寻找下标为 index 的值并修改,递归调用私有函数set(int treeIndex, int l, int r, int index, E e)。set(int treeIndex, int l, int r, int index, E e):修改元素成功后,对一个区间内的元素做 Merger 操作,实现动态更新。
-
线段树的原理:线段树除最后一层外是一棵满二叉树。假设区间中有 n 个数据,则倒数第二层节点数约为 n,从第一层到倒数第三层的节点数约为 n-1,最后一层节点数很少;但为了用数组存储整棵树,最后一层大约需要开 2n 的空间,因此一共需要开辟 4n 的空间来存储线段树。
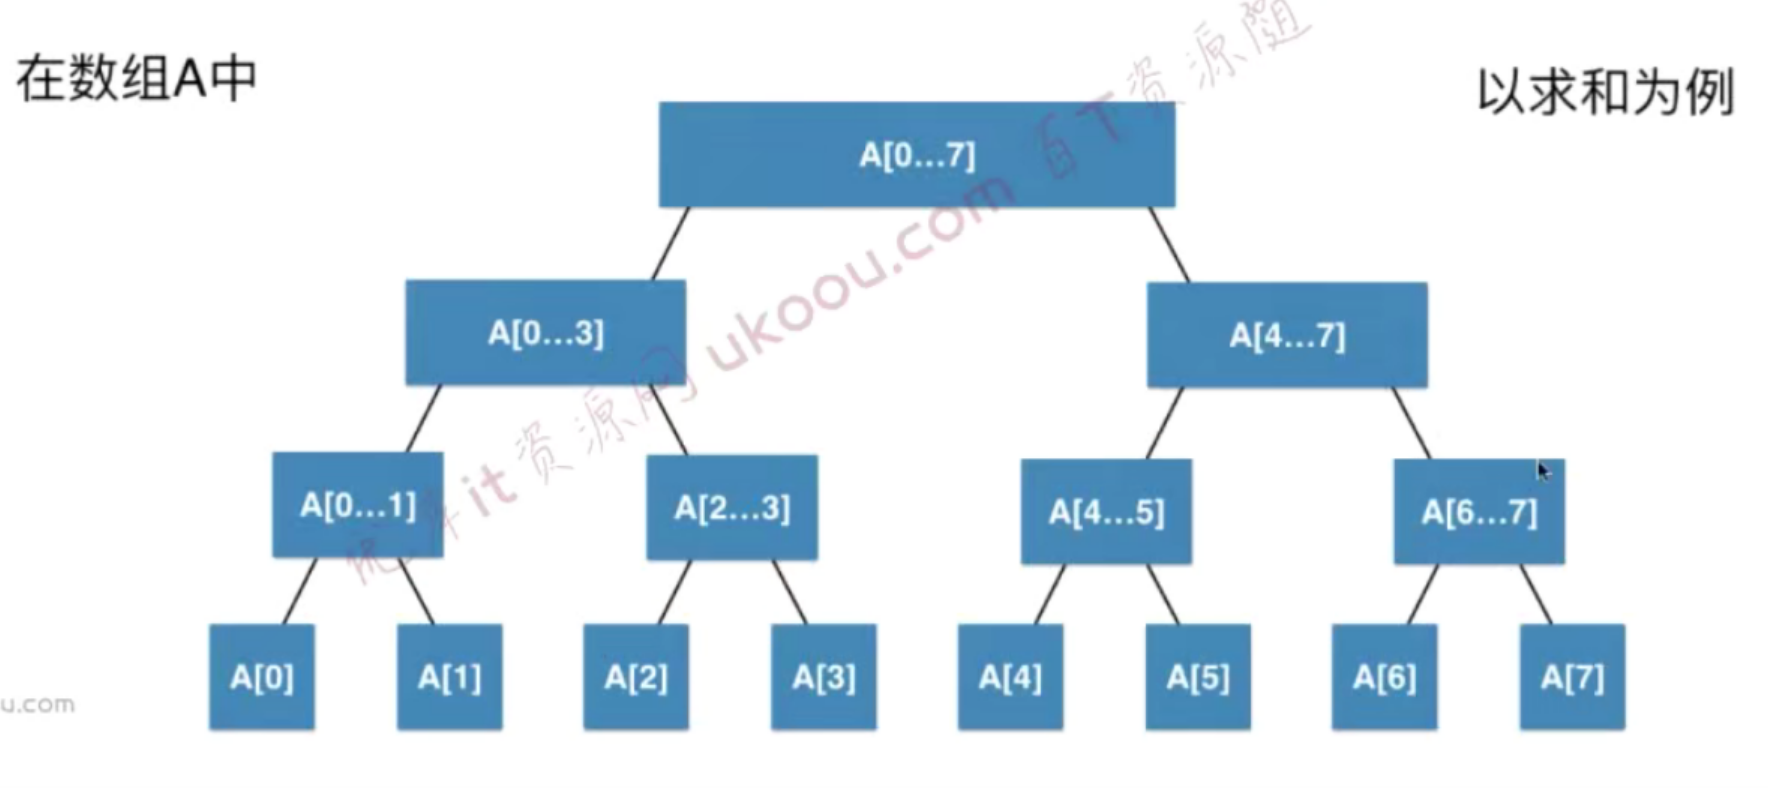
为了方便构造,A[0] 下面也要有两个 null 的左右子树,同理 A[1]~A[7] 也是。
这里让左子树的数目少于右子树,即区间分割时向下取整。
查询示例:查询区间 [2,5],从根节点出发。mid = 7/2 = 3(向下取整),由于 2<3 且 5>3,该区间跨越根节点的左右子树。进入左子树 [0,3] 作为根节点,mid = 3/2 = 1,因为 2>1,所以左子树区间为 [2,3];同理右子树区间为 [4,5]。最后将两个区间合并做 merger 操作。
//(1)SegmentTree 构造函数
 public SegmentTree(E[] arr, Merger<E> merger) {
          //对改merger操作进行初始化
        this.merger = merger;
        //!!将data类型 格式转化为Objiect 并赋予与arr.length 一样的空间
        data = (E[]) new Object[arr.length];
        for (int i = 0; i < arr.length; i++) {
            data[i] = arr[i];  //arr将数组中的值进行拷贝到data
        }
     //首先对线段树的内存空间进行初始化 并对其进行类型的转换然后才能接收到data[]内的值
        tree = (E[]) new Object[4 * arr.length];
        //建造线段树 (节点0,最小下标,和最大下标)
       //调用建造线段树的函数
        buildSegmentTree(0, 0, data.length - 1);
    }
   //当一切都进行初始化完毕然后就调用私有函数buildSegmentTree
//
private void buildSegmentTree(int treeIndex, int l, int r) {
        // 该函数是个递归函数 先考虑结束情况当r==l是程序结束 也就是只剩下一个叶子节点
        if (r == l) {
            tree[treeIndex] = data[r];  //将叶子节点挂在tree树上
            return;
        }
      //线段树的建造流程
       //首先进行中间下标的求解 这样写是为了防止越界
        int mid = l + (r - l) / 2;
      //得到左右孩子的下标用于作为根节点进行递归调用
        int leftTreeIndex = leftChild(treeIndex);
        int rightTreeIndex = rightChild(treeIndex);
    //开始递归的调用该函数首先以左孩子下标为跟节点建造 区间(L,mid)同理右孩子为(mid+1,r)
        buildSegmentTree(leftTreeIndex, l, mid);
        buildSegmentTree(rightTreeIndex, mid + 1, r);
    //当调用到底层的时候也就是 叶子节点 他们存的值为 自己左右孩子进行外部接口的merger操作后存入该节点 同理递归的往上调用
        tree[treeIndex] = merger.merge(tree[leftTreeIndex], tree[rightTreeIndex]);
    }
当线段树构造完成以后,完成上面函数所调用的若干辅助函数。
public E get(int index) {
       //获取下标为index的值 需要判断数组是否越界了
       if (index < 0 || index >= data.length)
           throw new IllegalArgumentException("Index is illegal");
         //然后在data数组中直接返回
       return data[index];
   }
   public int getSize() {
       return data.length;
   }
   private int leftChild(int index) {
       //根据二叉树的性质可以得出左孩子下标和有孩子下标
       return 2 * index + 1;
   }
   private int rightChild(int index) {
       return 2 * index + 2;
   }
当以上两步都完成的时候,可以进行查询区间的操作。
//该函数因为需要递归调用 所以要传入根节点 左右下标和 查询的左右区间下标
private E query(int treeIndex, int l, int r, int queryL, int queryR) {
    //首先对递归到第的情况进行判断 就是当l和r与查询的queryL,queryR的下标相同时直接返回根节点的值
    if (l == queryL && r == queryR) {
            return tree[treeIndex];
        }
    //正常流程先 求取中间值的下标
        int mid = l + (r - l) / 2;
    //得到左右孩子的下标
        int leftTreeIndex = leftChild(treeIndex);
        int rightTreeIndex = rightChild(treeIndex);
    //判断该区间是否在 线段树的右子树如果是的化就以右孩子为根节点搜寻[mid+1,r]内的值
        if (queryL >= mid + 1) {
            return query(rightTreeIndex, mid + 1, r, queryL, queryR);
        } else if (queryR <= mid) {
            //判断是否在左子树上 如果是则递归调用query直至找到
            return query(leftTreeIndex, l, mid, queryL, queryR);
        }
    //当即不再左子树又不在右子树上的时候就是mid在【queryL,queryR】的中间
    //则需要顶一个E 类型的变量分别接收最后返回的【l,mid】和[mid+1,r]的值
    //然后对两个区间的结果进行merger操作并返回
        E leftResult = query(leftTreeIndex, l, mid, queryL, mid);
        E rightResult = query(rightTreeIndex, mid + 1, r, mid + 1, queryR);
        return merger.merge(leftResult, rightResult);
    }
线段树的动态更新
拓展
以上是针对固定区间、固定数值的操作;现实中还需要在修改某个数据后更新整棵线段树,然后再查找区间做相关操作。具体函数如下。
//首先将位于index下标的值进行修改
public void set(int index, E e) {
    //每次进行下标搜查需要考虑是否越界和下标是否合法
        if (index < 0 || index >= data.length)
            throw new IllegalArgumentException("Index is illegal");
        data[index] = e;     //修改
        //调用set的重构函数对区间【0,data.lengt-1】内的一个下标进行修改为e
      set(0, 0, data.length - 1, index, e);
    }
 //重构函数定义为私有变量防止外部调用参数意义(根节点,左范围,右范围,索引值,要修改的值)
    private void set(int treeIndex, int l, int r, int index, E e) {
        //递归终止的条件就是当l==r也就是找到那个元素了
        if (l == r) {
            tree[treeIndex] = e;  //修改
            return;
        }
        //正常流程 首先得到中间的下标
        int mid = l + (r - l) / 2;
        //其次得到左右孩子的下标 后面递归使用
        int leftTreeIndex = leftChild(treeIndex);
        int rightTreeIndex = rightChild(treeIndex);
        //接着 `index >= mid + 1`:如果要搜查的值在右子树则对右子树递归调用以 rightTreeIndex为根节点
        if (index >= mid + 1) {
            set(rightTreeIndex, mid + 1, r, index, e);
        } else {  //反之则在左子树同右子树相同不过根节点换成了左孩子的下标值
            set(leftTreeIndex, l, mid, index, e);
        }
        //当找到后不是整个线段树的节点值都改变在index以后的值节点保持不变而在index以前的节点值要改变
        //所以这里直接调用调用merger函数即可以自动实现。
        tree[treeIndex] = merger.merge(tree[leftTreeIndex], tree[rightTreeIndex]);
    }
LeetCode 练习题讲解
LeetCode 303:区域和检索 - 数组不可变
LeetCode 303. 区域和检索 - 数组不可变:实现一个 NumArray 类,支持查询区间内元素的总和。解题步骤如下。
- 首先定义一个私有变量 sum 数组,存储从 0 到 n 各区间的总和。例如 sum[6] 表示 sum[0]+…+sum[5],因此 sum 的空间大小为 nums.length+1,且 sum[0]=0。
- 对数据成员进行初始化,将 nums 内的元素累加并拷贝到 sum 数组中。
- 实现 sumRange 方法返回结果。例如要求下标 [4,8] 区间内元素的总和,只需 sum[9]-sum[4]。
代码如下所示
public class NumArray {
    private int []sum;
    public NumArray(int []nums){
        sum=new int[nums.length+1];
        sum[0]=0;
        //对sum[1]~sum[n]逐个进行赋值 从i=1开始 sum[1]=sum[0]+nums[0];sum[2]=sum[1]+nums[1]...
        for (int i = 1; i < sum.length; i++) {
            sum[i]=sum[i-1]+nums[i-1];
        }
    }
    //返回最终结果
    public int sumRange(int i,int j){
        return sum[j+1]-sum[i];
    }
}
Trie 前缀树
概念介绍
**前缀树(Trie)**又称为字典树,是一种有序的树,用于保存关联数组,其中的键通常是字符串——即该节点对应的字符串。一般情况下,并非所有节点都有对应的值,只有叶子节点和部分内部节点对应的键才有相关值。
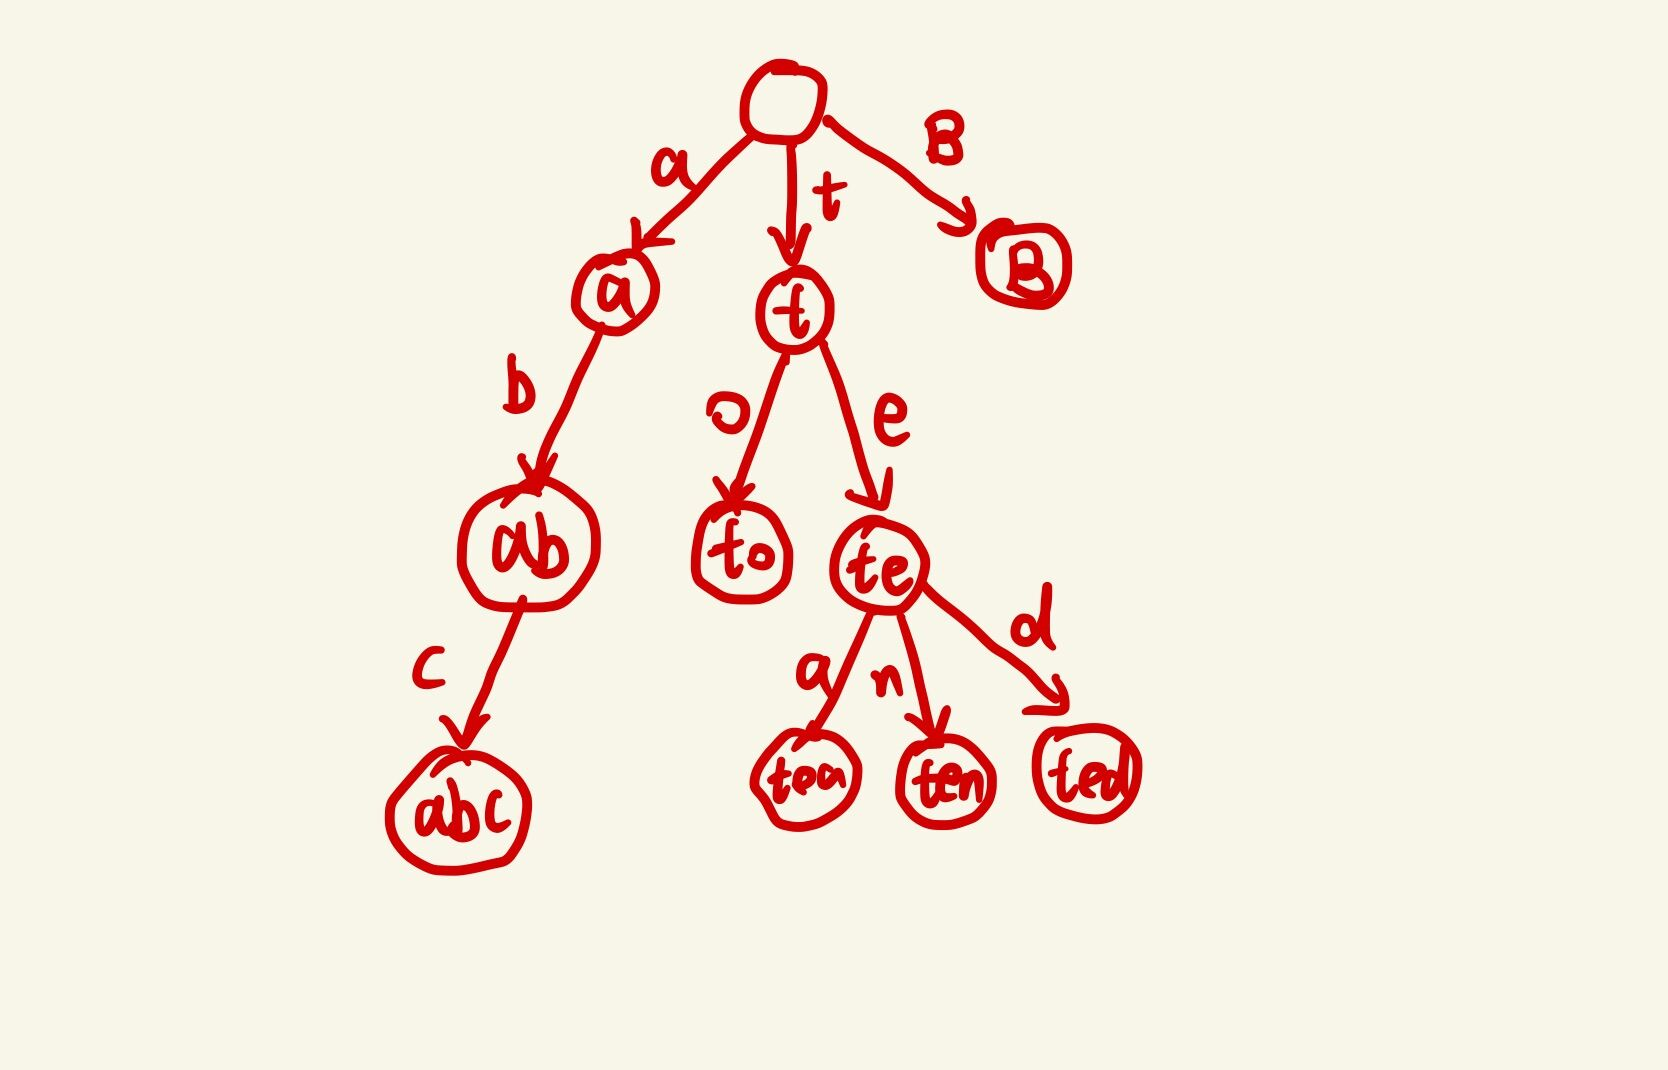
前缀树的 3 个基本性质
- 根节点不包含字符,除根节点外每一个节点都只包含一个字符。
- 从根节点到某一节点,路径上经过的字符连接起来,就是该节点对应的字符串。
- 每个节点的所有子节点包含的字符都不相同。
Trie 树的应用
常用于搜索提示,例如输入网址时出现可能的结果,也可用于聊天记录的检索。时间复杂度 O(logN)。
Trie 树的实现
- 首先定义节点类
class Node,其中成员如下: public boolean isWorld:表示到该节点是否构成一个单词。public TreeMap<Character, Node> next:表示下一个节点所存储的结构。Node(boolean isWorld):对节点和 next 进行初始化。- 接着定义
class Trie内的成员:Node root定义根节点;int size表示该 Trie 树的大小。 add(String word):添加单词 word。contains(String word):查询单词 word 是否在 Trie 中。isPrefix(String prefix):判断该单词是否是某个单词的前缀。
代码实现
定义节点内部类
  private class Node {
        public boolean isWorld;
        //Character是个假设 可以适用于不同的情况 能够分为一个一个的单元
        public TreeMap<Character, Node> next;

        public Node(boolean isWorld) {
            this.isWorld = isWorld;
            next = new TreeMap<>();
        }
//当该节点不是个单词的时候直接赋值为false
        public Node() {
            this(false);
        }
    }
定义 Trie 类的成员变量与构造方法
 	private Node root;
    private int size;
//初始化 Tire 并对成员变量初始化赋值
    public Trie() {
        root = new Node();
        size = 0;
    }
//得到该Trie树中单词的数目
    public int getSize() {
        return size;
    }
实现 add 方法:向 Trie 中添加单词
public void add(String word) {
    //首相从根节点开始 顶一个cur指针指向根节点
     Node cur = root;
     for (int i = 0; i < word.length(); i++) { //其对对传入的单词进行遍历
         char c = word.charAt(i);  //将第i个字母赋值给c
         if (cur.next.get(c) == null) {  //判断cur的下一个节点是否为空如果是的话,则新建一个节点直接将该字母放在cur.next的下一个节点
             cur.next.put(c, new Node());
         }
         //如果不为空的话让cur指针指向该不为空的节点便于下次循环操作
         cur = cur.next.get(c);
     }
    //当所有的节点都add上了后 此时判断该节点下的isWorld是否为true,不是的话改为true并且size++
     if (!cur.isWorld) {
         cur.isWorld = true;
         size++;
     }
 }
实现 contains 方法
//查询单词 word是否在Trie中
 public boolean contains(String word){
     Node cur=root;  //定义指针指向根节点
     for (int i = 0; i < word.length(); i++) { //遍历word单词
         char c=word.charAt(i);
         if(cur.next.get(c)==null){ //如果cur.next为空的话则直接判断不存在
             return false;
         }
         cur= cur.next.get(c);  //不为空的话 开始对下一个字母进行校验
     }
     return cur.isWorld;  //当上面的while循环完成 则直接返回cur.isWrold证明该单词存在
 }
实现 isPrefix 方法
public boolean isPrefix(String prefix){
    Node cur=root;
    for(int i=0;i<prefix.length();i++){
        char c=prefix.charAt(i);
        if(cur.next.get(c)==null){
            return false;
        }
        cur=cur.next.get(c);
    }
    return true;
}
LeetCode 题目讲解
- LeetCode 208. 实现 Trie (前缀树):与上文实现过程基本一致。
接口定义
class Trie {
    public Trie() {  //初始化
    }
    public void insert(String word) {  //增加
    }
    public boolean search(String word) {  //查找
    }
    public boolean startsWith(String prefix) {  //前缀
    }
}
代码实现
class Trie {
    private class Node {
        public boolean isWorld;
        //Character是个假设 可以适用于不同的情况 能够分为一个一个的单元
        public TreeMap<Character, Node> next;
        public Node(boolean isWorld) {
            this.isWorld = isWorld;
            next = new TreeMap<>();
        }
        public Node() {
            this(false);
        }
    }
    private Node root;
    public Trie() {
        root = new Node();
    }
    public void insert(String word) {
        Node cur = root;
        for (int i = 0; i < word.length(); i++) {
            char c = word.charAt(i);
            if (cur.next.get(c) == null) {
                cur.next.put(c, new Node());
            }
            cur = cur.next.get(c);
        }
        if (!cur.isWorld) {
            cur.isWorld = true;

        }
    }
    public boolean search(String word) {
        Node cur=root;
        for (int i = 0; i < word.length(); i++) {
            char c=word.charAt(i);
            if(cur.next.get(c)==null){
                return false;
            }
            cur= cur.next.get(c);
        }
        return cur.isWorld;
    }
    public boolean startsWith(String prefix) {
        Node cur=root;
        for (int i = 0; i < prefix.length(); i++) {
            char c=prefix.charAt(i);
            if(cur.next.get(c)==null)
                return false;
            cur=cur.next.get(c);
        }
        return true;
    }
}
-
LeetCode 211. 添加与搜索单词:设计一个数据结构,支持添加新单词,并查找字符串是否与先前添加的任何字符串匹配。
-
同样有内部节点 Node 类,定义与上文相同,这里不需要私有变量 size。
-
WordDictionary:对该字典类进行初始化。 -
addWord:与上文的 add 函数相同。 -
重点实现
search(String word)函数。
相同代码预览
private class Node {
      public boolean isWorld;
      //Character是个假设 可以适用于不同的情况 能够分为一个一个的单元
      public TreeMap<Character, Node> next;
      public Node(boolean isWorld) {
          this.isWorld = isWorld;
          next = new TreeMap<>();
      }
      public Node() {
          this(false);
      }
  }
  private Node root;
  public WordDictionary() {
      root = new Node();
  }
  public void addWord(String word) {
      Node cur = root;
      for (int i = 0; i < word.length(); i++) {
          char c = word.charAt(i);
          if (cur.next.get(c) == null) {
              cur.next.put(c, new Node());
          }
          cur = cur.next.get(c);
      }
      cur.isWorld = true;
  }
重点实现:search 与 match 方法
public boolean search(String word) {
     return match(root, word, 0);  //调用match函数从根节点开始 word单词 0为下标
 }
接着实现 match 方法
//从根节点开始 搜查单词为word 下标为index=0开始
private boolean match(Node node, String word, int index) {
        if (index == word.length()) {  //首先判断递归到底的情况就是index=单词的长度
            return node.isWorld;  //返回true 证明找到了
        }
    //先取出word的第一个字母进行匹配
        char c = word.charAt(index);
        if (c != '.') {  //因为体感说'.'表示一个任意的字母 当不为.的时候
            if (node.next.get(c) == null) {  //先判断c的下一个单词是否存在 不存在直接返回false
                return false;
            }
            //如果存在的话就递归调用以当前node.next.get(C)为节点 index+1 为下标的匹配函数
            return match(node.next.get(c), word, index + 1);
        } else {
            //当然当下一个单词为'.'的时候可以直接遍历nextChar数组的 ‘keySet()’--它表示的是取出word的下一个字母
            for (char nextChar :
                    node.next.keySet()) {
                // 此处以下一个字母为根节点 查找word 然后下标继续为index+1
                if (match(node.next.get(nextChar), word, index + 1))
                    return true;
            }
            return false;
        }
    }