并查集
**并查集(Union-Find)**是一种树形数据结构,用于处理不相交集合的合并与查询问题。它本质上是借助一个一维数组来维护一片森林,初始时每个节点孤立成树,经过若干次合并操作后,逐棵合并为更大的树。
概论
定义
并查集是一种树形的数据结构,用于处理一些不相交集合的合并以及查询问题,它的本质是通过一个一维数组来维护一个森林。开始时森林中的每一个节点都是孤立的,各成一棵树;进行若干次的合并操作,每次合并将两棵树合并为一棵更大的树。
主要解决问题:连接问题和路径问题。
并查集在一些有 N 个元素的集合应用问题中,通常在开始时让每个元素构成一个单元素的集合,然后按一定顺序将属于同一组的元素所在的集合合并,其间要反复查找一个元素在哪个集合中。
操作
- 将两个集合合并
- 询问两个数是否在一个集合中
基本原理
每个集合用一棵树来表示。树根的编号就是整个集合的编号,每个节点存储它的父节点,也就是孩子指向父亲。
Quick Find 实现
公共接口:设计两个接口,主要对其下标进行比较,isConnected 判断是否联合,unionElements 联合两个节点。
int getSize();
boolean isConnected(int p,int q);
void unionElements(int p,int q);
id 0 1 2 3 4 5 6 7 8 9
parent 0 1 0 1 0 1 0 1 0 1
由上述格式可知,判断两个元素是否连接可以比较它们的下标值是否相同,完成
find()函数。
private int find(int p){
    if(p<0&&p>=id.length){
         throw new IllegalArgumentException("p is out of bound!");
    }
    return id[p];
}
接着实现
isConnected()函数,主要判断两个元素是否属于同一个集合,其中 p、q 是编号。
public boolean isConnected(int p, int q) {
       return find(p)==find(q);
   }
实现两个编号下元素的融合
unionElements()。
pubilc void unionElements(int p,int q){
    int pID=find(p);
    int qID=find(q);
    if(pID==qID){
        return;
    }
    for(int i=0;i<id.length;i++){
        if(id[i]==pID)
            id[i]=qID;
    }
}
这里我们拿上面的 id 和 parent 的例子,当编号 1 和 4 融合后的结果为:
id 0 1 2 3 4 5 6 7 8 9
parent 0 0 0 0 0 0 0 0 0 0
因为上面的 id 一共可以分为两波,当把它们不同的两个连接起来,相当于整个元素全部连接了起来。
公共接口类
以下不同的优化均需要用到该接口。
public interface UF {
    //设计两个接口 主要对其下标进行比较
    int getSize();
    boolean isConnected(int p,int q);
    void unionElements(int p,int q);
}
程序源代码
public class UnionFind1 implements UF {
    private int[] id;

    public UnionFind1(int size) {
        id = new int[size];
        for (int i = 0; i < id.length; i++) {
            id[i] = i;
        }
    }

    private int find(int p) {
        if (p < 0 && p >= id.length) {
            throw new IllegalArgumentException("p is out of bound!");
        }
        return id[p];
    }

    @Override
    public int getSize() {
        return id.length;
    }

    @Override
    public boolean isConnected(int p, int q) {
        return find(p) == find(q);
    }

    @Override
    public void unionElements(int p, int q) {
        int pID = find(p);
        int qID = find(q);
        if (pID == qID) {
            return;
        }
        for (int i = 0; i < id.length; i++) {
            if (id[i] == pID)
                id[i] = qID;
        }
    }
}
Quick Union
将每一个元素看做是一个节点。该过程适用于有序序列从 0 开始。
id 0 1 2 3 4 5 6 7 8 9
parent 0 1 2 3 4 5 6 7 8 9
根据下图可以看出联合过程,每次联合元素都找到它的祖先,让祖先进行连接。
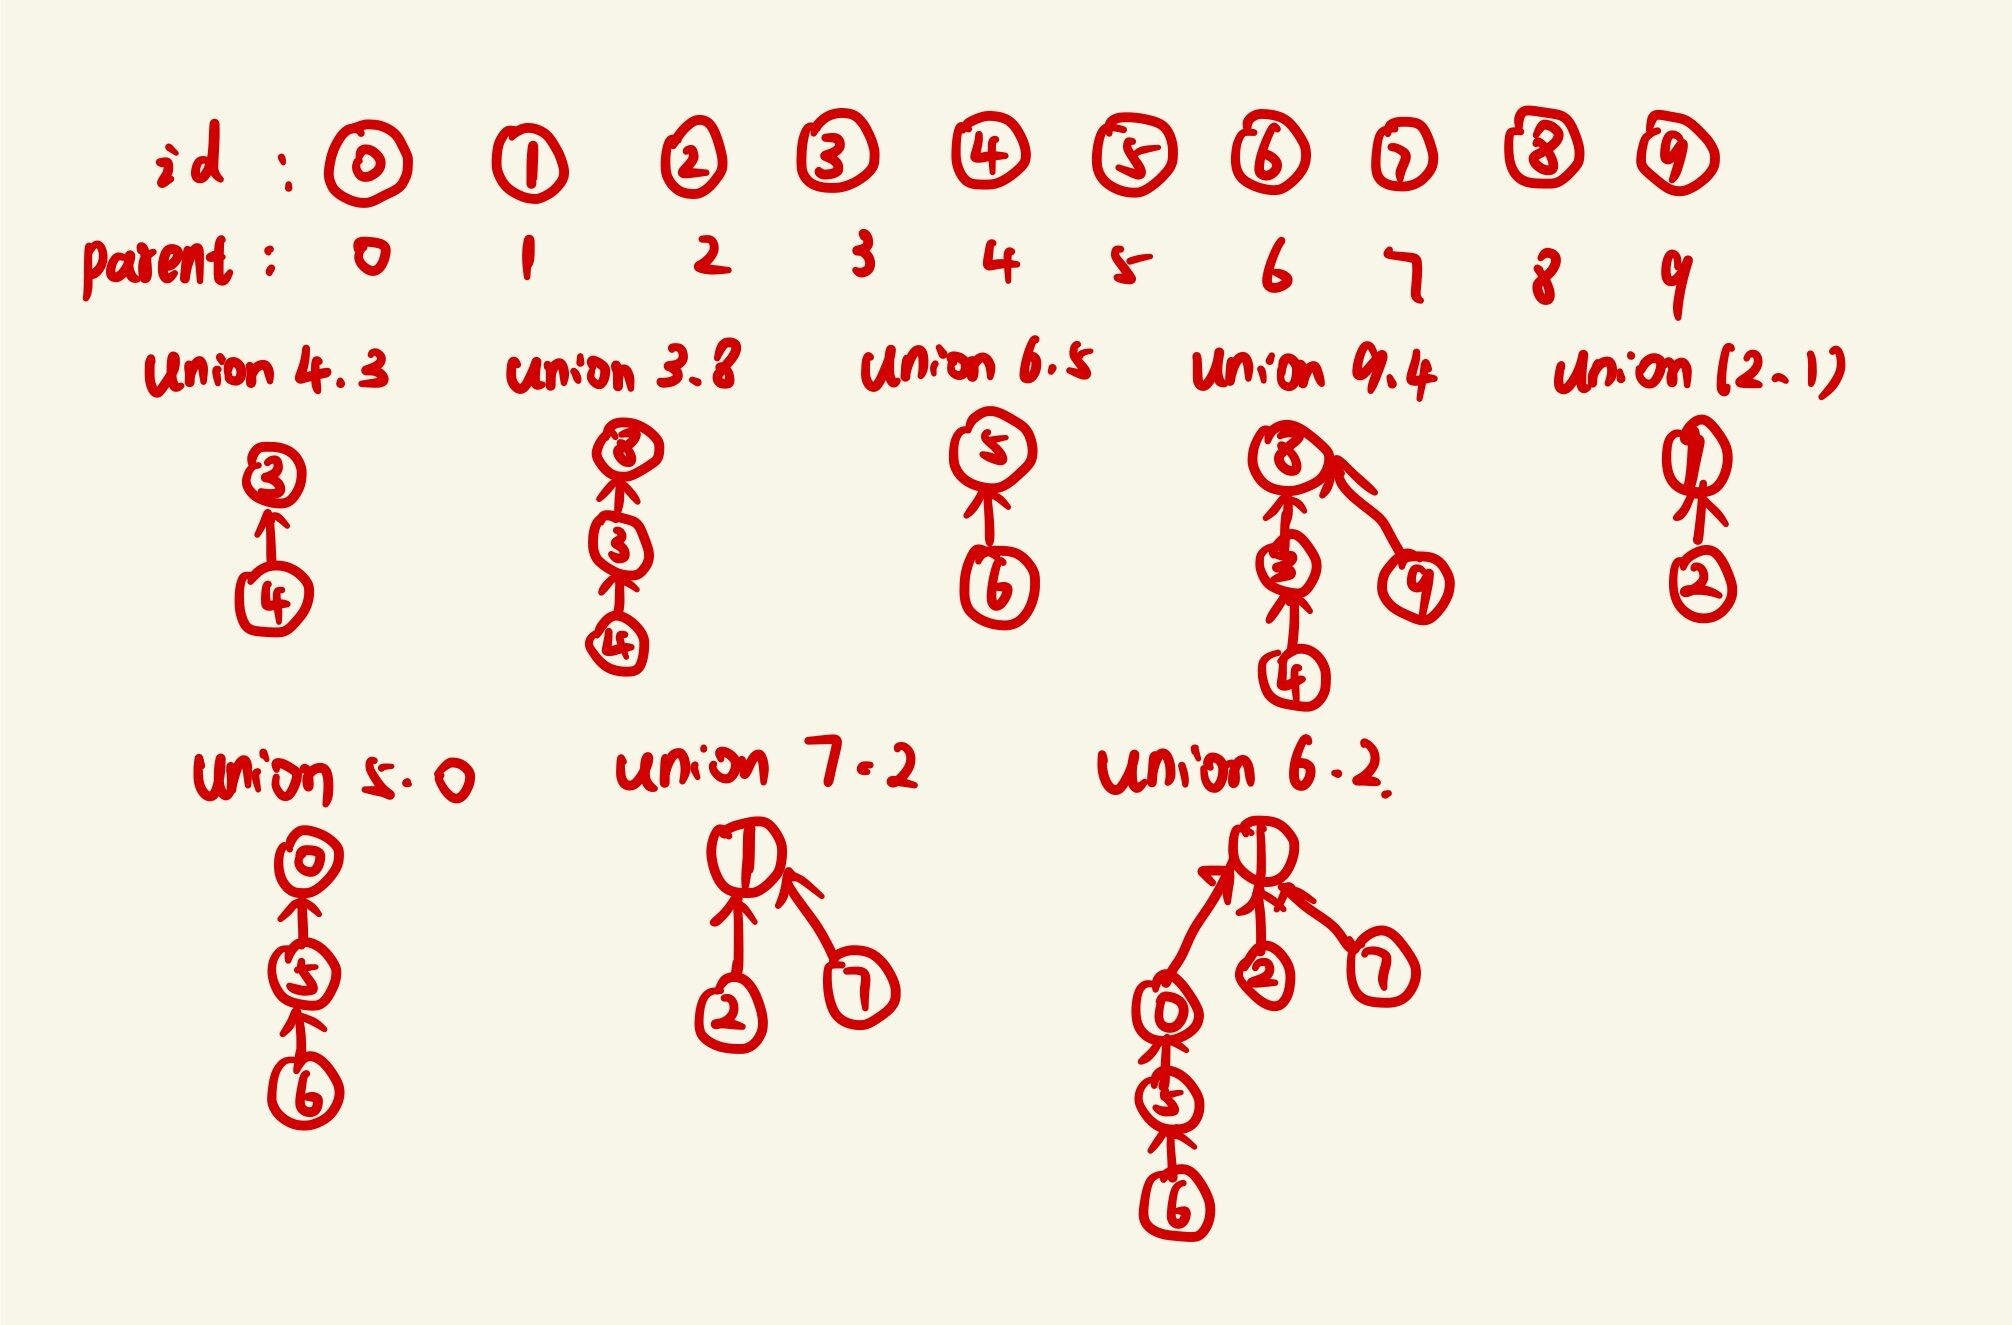
图片解析:对于 union(4,3),这里规定将 4 连接到 3;起初它们都是孤立的节点,指向自己本身即 p=parent(p)。连接 4、3 时首先找到 4、3 的根节点都为其本身,其次让 4 的根节点指向 3,即 4 的祖先指向 3——先存储 4、3 的祖先为 pRoot、qRoot,然后执行 parent[pRoot]=qRoot,就实现了连接。
所以可以对
find()函数进行修改,每次需要找到它的祖先,初始化的时候让 id==parent。
private int find(int p){
     if(p<0&&p>=id.length){
         throw new IllegalArgumentException("p is out of bound!");
    }
    //此处开始寻找其祖先
    while(p!=parent[p]){
        p=parent[p];
    }
    return p;
}
对联合两组元素的情况,最终代码让 parent 指向根节点。
public void unionElements(int p, int q) {
    //得到p的根节点
    int pRoot = find(p);
    //得到q的根节点
    int qRoot = find(q);
     if (pRoot == qRoot) {
           return;
       }
    //最终让pRoot指向qRoot实现了连接
       parent[pRoot] = qRoot;
   }
程序源代码
import java.util.Arrays;

public class UnionFind2 implements UF {
    private int[] parent;

    public UnionFind2(int size) {
        parent = new int[size];
        for (int i = 0; i < size; i++) {
            parent[i] = i;
        }
    }

    @Override
    public int getSize() {
        return parent.length;
    }

    private int find(int p) {
        if (p < 0 && p >= parent.length)
            throw new IllegalArgumentException("p is out of bound");
        while (p != parent[p]) {
            p = parent[p];
        }
        return p;
    }

    //判断p和q是否在同一个集合
    @Override
    public boolean isConnected(int p, int q) {
        return find(p) == find(q);
    }

    @Override
    public void unionElements(int p, int q) {
        int pRoot = find(p);
        int qRoot = find(q);
        if (pRoot == qRoot) {
            return;
        }
        parent[pRoot] = qRoot;
    }
}
基于 size 的优化
在第二版的并查集中,find() 是一个不断索引的过程,不是顺次访问,而是在不同的地址跳转,所以访问较慢,其复杂度为 O(h),isConnected() 复杂度高。
为了使形成的树不会因为不断连接而形成一条链表,让元素少的根节点指向元素多的根节点,如下图:
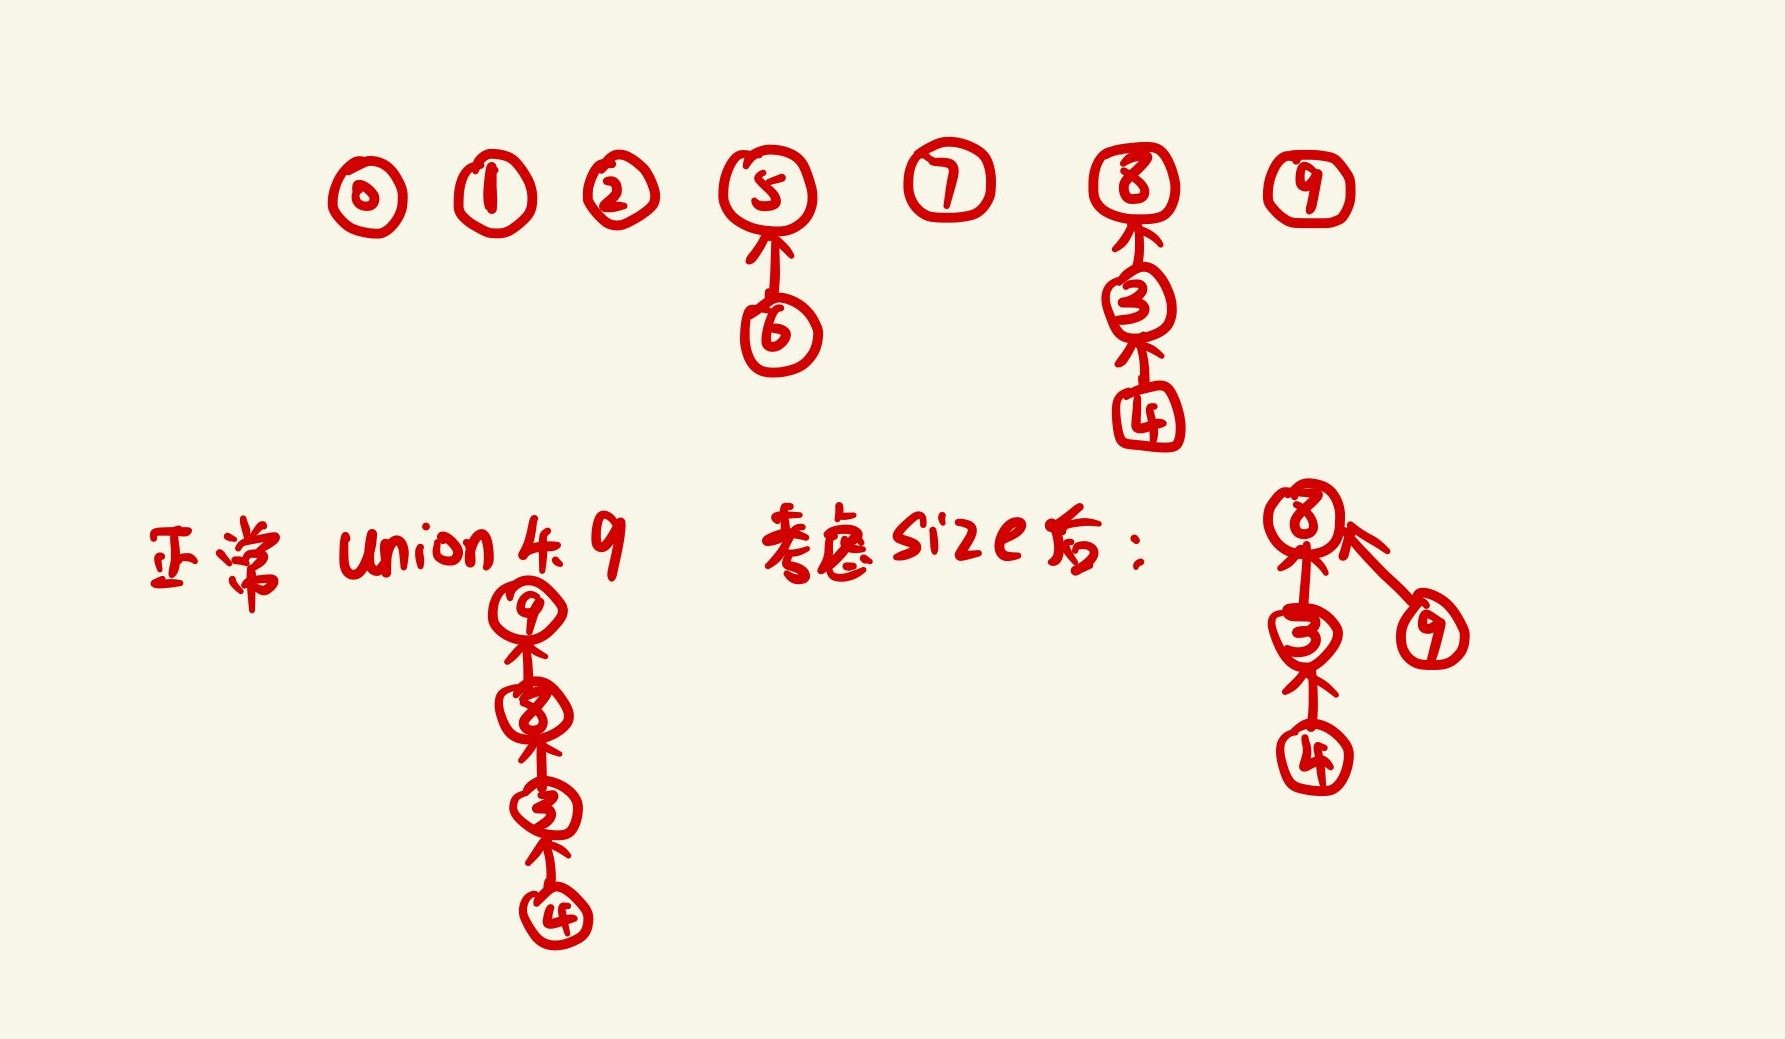
按照正常情况连接成一条链表增加了树的高度,提升了时间复杂度,使效率变慢。但考虑到 size 情况后,可以让元素少的指向元素多的,这样就避免了单链表的形成。
具体修改代码如下:
- 首先添加私有成员变量
private int []sz,表示以 i 为根的集合中元素的个数 - 修改构造函数,初始化数组时为每个节点添加
sz[i]=1 find()函数和第二版一致unionElements()函数进行修改,操作如下:
public void unionElements(int p,int q){
    int pRoot=find(p);
    int qRoot=fin(q);
    if(pRoot==qRoot){
        return;
    }
    //以下判断size的大小进行不同的连接方式可以实现树的深度降低;
    if(sz[pRoot]<sz[qRoot]){
        parent(pRoot)=qRoot;
        sz[qRoot]+=sz(pRoot);
    }else{
        parent[qRoot]=pRoot;
        sz[pRoot]+=sz[qRoot];
    }
}
程序源代码
import java.util.Arrays;

//基于size的优化
public class UnionFind3 implements UF {
    private int[] parent;
    private int[] sz;  //sz[i]表示以i为根的集合中元素的个数

    public UnionFind3(int size) {
        parent = new int[size];
        sz = new int[size];
        for (int i = 0; i < size; i++) {
            parent[i] = i;
            sz[i] = 1;
        }
    }

    @Override
    public int getSize() {
        return parent.length;
    }

    private int find(int p) {
        if (p < 0 && p >= parent.length)
            throw new IllegalArgumentException("p is out of bound");
        while (p != parent[p]) {
            p = parent[p];
        }
        return p;
    }

    //判断p和q是否在同一个集合
    @Override
    public boolean isConnected(int p, int q) {
        return find(p) == find(q);
    }

    @Override
    public void unionElements(int p, int q) {
        int pRoot = find(p);
        int qRoot = find(q);
        if (pRoot == qRoot) {
            return;
        }
        if (sz[pRoot] < sz[qRoot]) {
            parent[pRoot] = qRoot;
            sz[qRoot] += sz[pRoot];
        } else {
            parent[qRoot] = pRoot;
            sz[pRoot] += sz[qRoot];
        }

    }
}
基于 rank 的优化
目的:为了使每次两个不同的集合连接后树的高度尽量不增加,此处进行 rank 优化。代码与基于 size 优化代码类似,只不过将 private int []sz 改为 private int []rank,并在构造函数中赋予初始高度为 1。
下面主要修改 unionElements() 函数。
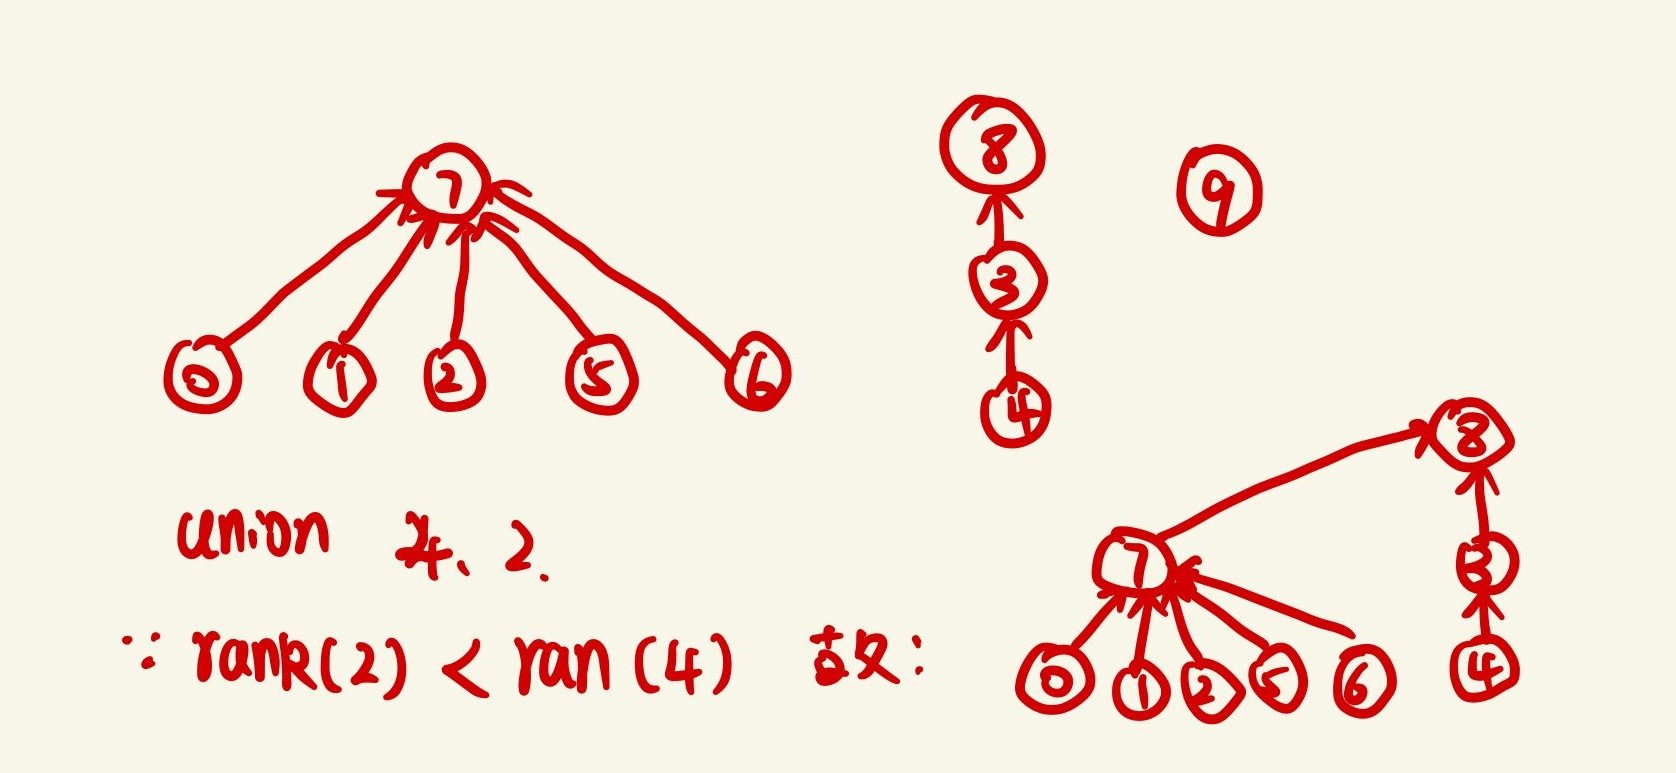
public void unionElements(int p,int q){
    int pRoot=find(p);
    int qRoot = find(q);
    if (pRoot == qRoot) {
       return;
     }
    //根据两个元素所在树的rank不同判断合并的方向
    //将rank低的集合合并到rank高的集合上,代码实现逻辑如下
    if(rank[pRoot]<rank[qRoot]){
        parent[pRoot]=qRoot;
    }else if(rank[qRoot]<rank[pRoot]){
        parent[qRoot]=pRoot;
    }else{
        //当两个的rank相同时则合并后整体高度+1
        parent[qRoot]=pRoot;
        rank[pRoot]+=1;
    }
}
基于 rank 的优化和路径压缩
目的:解决单链表的问题。这个解决方法发生在 find 过程中,在 find 过程中实现路径压缩,在向上遍历的时候执行 parent[p]=parent[parent[p]]。整体代码和基于 rank 的代码相同,原理图如下:
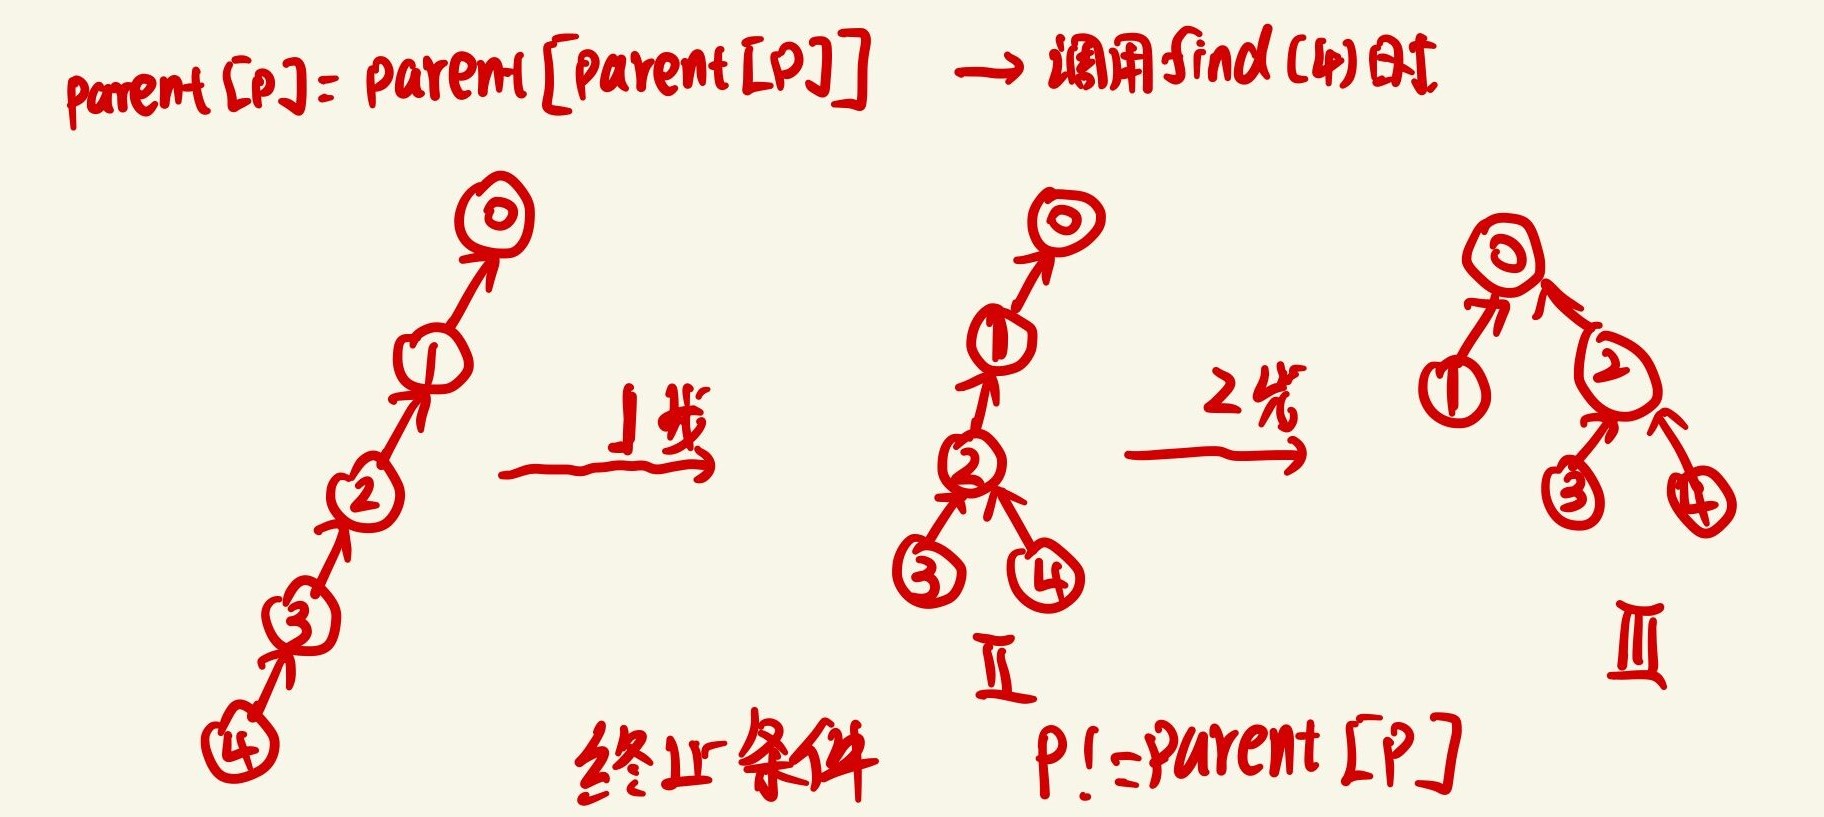
图片解析:首先当 find(4) 的时候让其 parent 指向父亲的父亲,也就是 2;其次构成树 Ⅱ,然后走向节点 2 让其 parent 指向父亲的父亲,构成树 Ⅲ,当 p != parent[p] 时终止,此时优化已经完成。
find() 代码如下:
  private int find(int p) {
        if (p < 0 && p >= parent.length)
            throw new IllegalArgumentException("p is out of bound");
        while (p != parent[p]) {
            parent[p] = parent[parent[p]];
            p = parent[p];
        }
        return p;
    }

//也可以递归的实现find的路径压缩
   //find的递归实现
    private int find(int p) {
        if (p < 0 && p >= parent.length)
            throw new IllegalArgumentException("p is out of bound");
        if (p != parent[p]) {
            //路径压缩
            parent[p] = find(parent[p]);
        }
        return parent[p];
    }
程序源代码
import java.util.Arrays;

public class UnionFind6 implements UF {
    private int[] parent;
    private int[] rank;  //sz[i]表示以i为根的集合中元素的个数

    public UnionFind6(int size) {
        parent = new int[size];
        rank = new int[size];
        for (int i = 0; i < size; i++) {
            parent[i] = i;
            rank[i] = 1;
        }
    }

    @Override
    public int getSize() {
        return parent.length;
    }

    //find的递归实现
    private int find(int p) {
        if (p < 0 && p >= parent.length)
            throw new IllegalArgumentException("p is out of bound");
        if (p != parent[p]) {
            //路径压缩
            parent[p] = find(parent[p]);
        }
        return parent[p];
    }
    //判断p和q是否在同一个集合
    @Override
    public boolean isConnected(int p, int q) {
        return find(p) == find(q);
    }

    @Override
    public void unionElements(int p, int q) {
        int pRoot = find(p);
        int qRoot = find(q);
        if (pRoot == qRoot) {
            return;
        }
        //根据两个元素所在树的rank不同判断合并的方向
        //将rank低的集合合并到rank高的集合上
        if (rank[pRoot] < rank[qRoot]) {
            parent[pRoot] = qRoot;
        } else if (rank[qRoot] < rank[pRoot]) {
            parent[qRoot] = pRoot;
        } else {
            parent[qRoot] = pRoot;
            rank[pRoot] += 1;
        }
    }
}